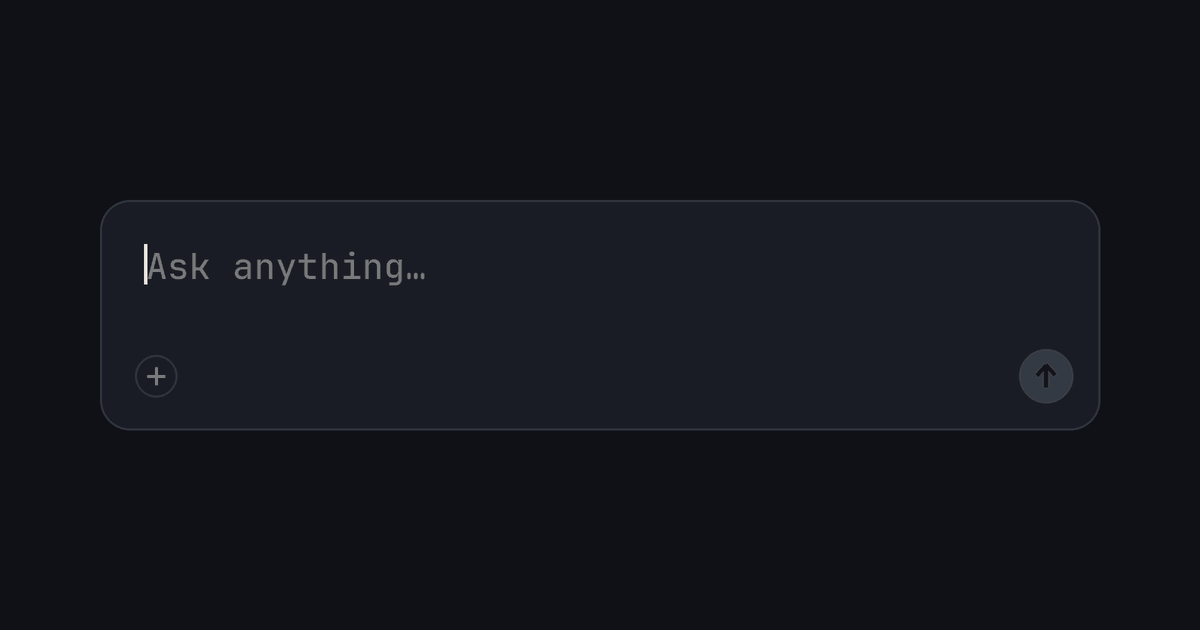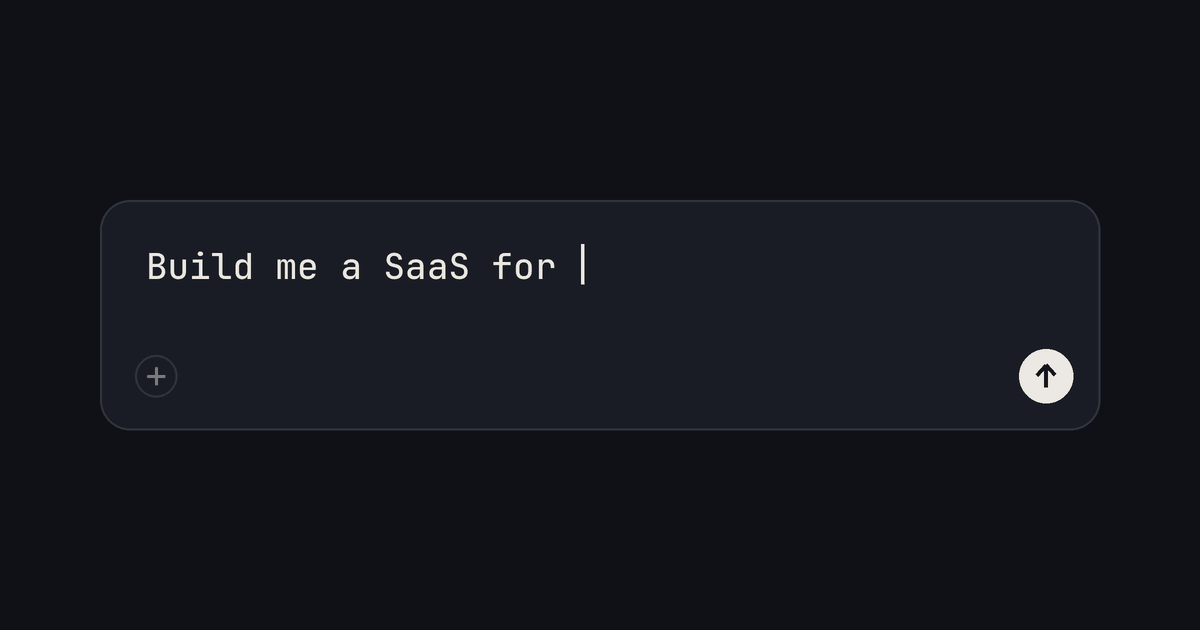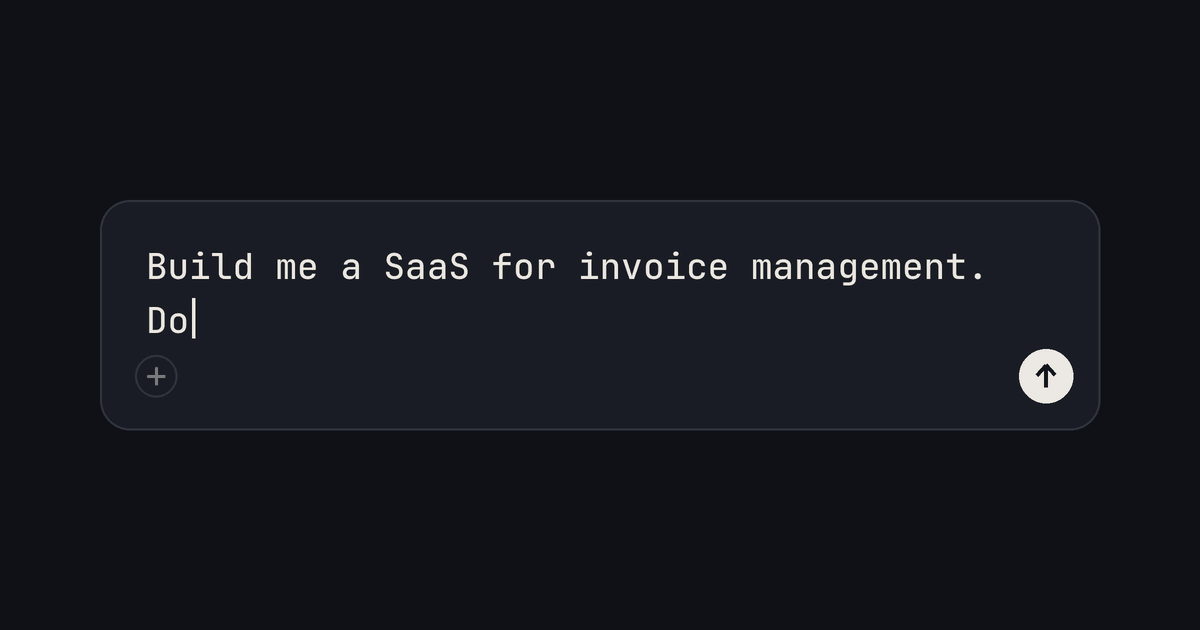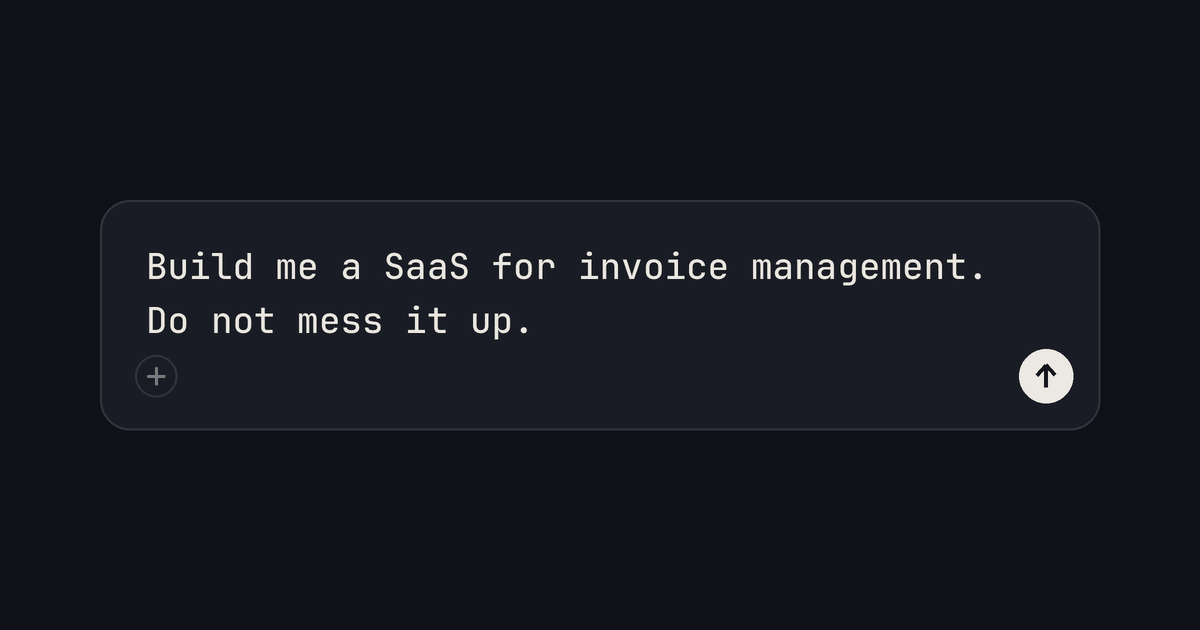
„Bau mir ein SaaS für Rechnungsverwaltung. Make no mistakes.“
Diesen letzten Satz lese ich immer wieder. Zuerst als Witz auf X und in Programmer-Humor-Feeds, dann, und da bin ich hängen geblieben, in echten Prompts, die mir Kolleginnen, Kollegen und Kunden zeigen. Mal heißt es „make no mistakes“, mal „do not mess it up“, „sei zu 100 % korrekt“ oder „halluziniere nicht“. Die Absicht ist immer dieselbe: Wenn ich nur nachdrücklich genug frage, strengt sich das Modell mehr an.
Stimmt das? Wird eine KI durch eine höfliche oder strenge Bitte sorgfältiger, denkt sie länger nach, recherchiert sie gründlicher? Ich habe mir angesehen, woher diese Formeln kommen und was die Forschung im Herbst 2026 dazu sagt.
Eine kurze Geschichte der Zauberworte
Die Idee, dass ein einzelner Satz bessere Antworten freischaltet, ist kein Aberglaube aus dem Nichts. Sie hat einen echten Ursprung.
2022 zeigten Kojima et al., dass der Zusatz „Let’s think step by step“ unter einer Matheaufgabe OpenAIs text-davinci-002 im MultiArith-Benchmark von 17,7 % auf 78,7 % Genauigkeit hob. Magie war das nicht. Der Satz brachte das Modell dazu, Zwischenschritte auszuschreiben, und diese Schritte wurden zum Kontext für die finale Antwort. Die Worte veränderten, was das Modell erzeugte, nicht, wie sehr es sich anstrengte.
Danach begann die Folklore. 2023 ließ Google DeepMind im OPRO-Paper ein Modell automatisch Prompts optimieren, und der Gewinner für PaLM 2 lautete „Take a deep breath and work on this problem step-by-step“. Im selben Jahr berichteten die Forschenden hinter EmotionPrompt von Verbesserungen durch Sätze wie „This is very important to my career“. Kurz darauf boten Leute ihren Chatbots Trinkgeld an.
2026 war „make no mistakes“ dann das Vibe-Coding-Meme schlechthin: das imaginäre --no-bugs-Flag am Ende einer einzeiligen Produktspezifikation. Es hat sogar die Chefetagen im Silicon Valley erreicht. Im Mai 2026 teilte Marc Andreessen einen Custom Prompt, der das Modell unter anderem anwies, „never hallucinate or make anything up“, und erntete dafür reichlich Spott.
Das Muster ist auffällig. Jede dieser Formeln wurde an einem bestimmten Modell, mit einem bestimmten Benchmark, zu einem bestimmten Zeitpunkt gemessen. Dann ist sie entkommen und zum allgemeingültigen Ratschlag geworden.
Was die Forschung 2026 sagt
Die Wissenschaft hat die Folklore eingeholt, und das Urteil fällt bemerkenswert einheitlich aus.
- Trinkgeld und Drohungen: Der Prompting Science Report 3 der Wharton Generative AI Labs schickte fünf Modelle, darunter GPT-4o und o4-mini, durch Wissenschaftsfragen auf Promotionsniveau, mit 25 Durchläufen pro Frage. Eine Billion Dollar Trinkgeld, die Drohung, einen Welpen zu treten, „das ist wichtig für meine Karriere“: insgesamt kein signifikanter Effekt. Bei einzelnen Fragen verschob dieselbe Variation die Genauigkeit allerdings um bis zu 36 Prozentpunkte in die eine oder andere Richtung, ohne dass sich vorhersagen ließ, in welche.
- Emotionaler Druck: TEMPER, veröffentlicht im April 2026 und für die COLM 2026 angenommen, testete 18 Modelle von 1 Milliarde Parametern bis zur Frontier-Klasse. Dieselbe Matheaufgabe in emotionaler Sprache half nicht. Sie senkte die Genauigkeit um 2 bis 10 Prozentpunkte. Eine neutrale Umformulierung holte den Großteil des Verlusts zurück. Eine zweite Studie vom April 2026, Do Emotions in Prompts Matter?, kam zu dem Schluss, dass emotionale Präfixe meist nur kleine Veränderungen bewirken, eher eine leichte Störung als ein Hebel.
- „Think step by step“: Selbst die eine Formel, die wirklich funktioniert hat, hat ihren Glanz verloren. Wharton fand in seinem Bericht zu Chain of Thought Zugewinne von rund 3 % bei o3-mini und o4-mini, ein Minus von 3,3 % bei Gemini 2.5 Flash und 20 bis 80 % mehr Antwortzeit. Reasoning-Modelle denken ohnehin nach; sie dazu aufzufordern, kostet vor allem Zeit.
Fairerweise: Keine dieser Studien untersucht „make no mistakes“ isoliert. Die Formel gehört aber zur selben Familie, und diese Familie verhält sich bestenfalls wie Rauschen und schlimmstenfalls wie eine Ablenkung.
Warum „make no mistakes“ nicht so funktionieren kann, wie man hofft
Überlege einmal, was der Satz voraussetzt. Er geht davon aus, dass das Modell einen schludrigen Standardmodus und einen sorgfältigen Modus hat und man nur den Schalter noch nicht gefunden hat. Könnte ein Modell aber erkennen, welche seiner Ausgaben Fehler sind, würde es sie gar nicht erst erzeugen. Eine halluzinierte API-Methode fühlt sich für das Modell nicht falsch an; sie ist schlicht die plausibelste Fortsetzung, die es gerade hat. Die Bitte, nicht zu halluzinieren, liefert ihm das fehlende Wissen nicht nach.
Die Zahlen bestätigen das. Im Hallucination Leaderboard von Vectara, aktualisiert im September 2026, halluziniert selbst das bestplatzierte Modell, GPT-5.4, noch in 7 % der Dokumentzusammenfassungen. Starke Frontier-Modelle liegen zwischen 9 und 12 %.
Beim Reasoning ist es ähnlich. Alle drei großen Anbieter steuern die Denktiefe inzwischen über explizite Einstellungen: effort bei Anthropic, reasoning_effort bei OpenAI, Thinking-Budgets und -Level bei Google. Wer gründlicheres Nachdenken will, dreht an diesem Regler, statt lauter zu werden. Ein Allheilmittel ist aber auch der Regler nicht: Im selben Leaderboard halluzinierte GPT-5.2 mit hohem Effort etwas häufiger (10,8 %) als mit niedrigem (8,4 %).
Lauter werden kann sogar schaden, und alle drei Anbieter sagen das auch. Anthropics Prompting-Leitfaden weist darauf hin, dass neuere Claude-Modelle dem System-Prompt genauer folgen als ihre Vorgänger, sodass Anweisungen in Großbuchstaben heute zu Überreaktionen führen; statt „CRITICAL: You MUST use this tool when…“ empfiehlt er ein schlichtes „Use this tool when…“. OpenAIs GPT-5-Leitfaden beschreibt, wie eine „Be THOROUGH“-Anweisung das Modell dazu brachte, Suchwerkzeuge immer wieder aufzurufen. Und Googles Gemini-Leitfaden, aktualisiert im September 2026, rät schlicht von unnötiger oder übermäßig überredender Sprache ab. Moderne Modelle hören zu. Anschreien ist nicht nötig.
Schadet „make no mistakes“? Vermutlich kaum. Hilft es? Dafür, dass es das zuverlässig tut, gibt es keinen Beleg.
Was du stattdessen schreiben solltest
Wenn „make no mistakes“ ein Wunsch ist, dann ist die Alternative eine Definition. Sag dem Modell, was in deinem Kontext ein Fehler ist, gib ihm eine Möglichkeit, seine Arbeit zu prüfen, und erlaube ihm, Unsicherheit zuzugeben. Anthropics Leitfaden zur Reduzierung von Halluzinationen nennt genau das als allererste Strategie: dem Modell ausdrücklich „Ich weiß es nicht“ erlauben.
So sieht der Unterschied in der Praxis aus:
# Der Wunsch
Bau den Rechnungsexport. Mach keine Fehler.

# Die Definition
Bau einen CSV-Export für Rechnungen in src/billing/export.ts.
- Beträge sind Ganzzahlen in Cent; verwende niemals Floats.
- Datumsangaben sind ISO 8601 in UTC.
- Führe `npm test -- billing` aus und behebe alle Fehler, bevor du fertig bist.
- Wenn eine Anforderung mehrdeutig ist oder du nicht prüfen kannst,
  ob eine API existiert, halte an und frag nach, statt zu raten.
Der zweite Prompt verlangt keine Perfektion. Er gibt dem Modell Akzeptanzkriterien, eine Feedbackschleife und einen Notausgang. Genau diese Kombination reduziert Fehler tatsächlich, und es ist dasselbe, was du einer neuen Kollegin oder einem neuen Kollegen am ersten Tag mitgeben würdest.
Noch eine Idee aus Anthropics Leitfaden, die mir sehr gefällt: Erkläre das Warum. Statt „NEVER use ellipses“ schlägt Anthropic vor, dem Modell zu sagen, dass seine Ausgabe von einer Text-to-Speech-Engine vorgelesen wird, die Auslassungspunkte nicht aussprechen kann. Aus einer Begründung kann ein Modell verallgemeinern; einer nackten Regel kann es nur gehorchen. Ich musste bei dem Beispiel kurz schmunzeln, denn die Agent-Konfiguration genau dieses Blogs enthält ebenfalls eine Regel zu Auslassungspunkten. Meine erklärt, wie mir gerade auffällt, nicht, warum. Steht jetzt auf der Liste.
Wenn du also das nächste Mal „make no mistakes“ tippen willst, frag dich, vor welchem Fehler du eigentlich Angst hast, und schreib genau das hin. Welche Zauberformel steckt noch in deinen Prompts, und hast du je getestet, ob sie überhaupt etwas bewirkt?